O agente disse que terminou. Ainda preciso ver o resultado.
Parte II: Verificação, controle humano e uma arquitetura que impede os erros de se multiplicarem
O que este artigo aborda
Um agente pode terminar uma tarefa e deixar um erro que o próximo agente passa a tratar como fato. Examino como isso acontece, qual evidência quero ver antes de aceitar o trabalho e onde o controle humano consegue mudar o resultado. A revisão por modelo ajuda, mas quero que o sistema confira o trabalho com algo além da própria explicação.
Artigo completo
Com que velocidade um erro razoável consegue viajar?
Na Parte I, escrevi sobre contratos, responsabilidade e estado fora da conversa. Essas fronteiras tornam o sistema compreensível. Não provam que o resultado esteja correto.
Agora imagine que um agente escreve uma regra convincente num módulo. Um segundo cria testes para aquele comportamento. Um terceiro atualiza a documentação. O resultado entra numa base de conhecimento. Uma semana depois, outro agente recupera o documento e o cita como política do projeto.
A essa altura, encontrar a suposição original fica difícil. O código, os testes e a documentação parecem confirmar uns aos outros, embora tenham nascido do mesmo erro.
Esse é o verdadeiro problema de escala. Modelos erram, pessoas também. A diferença está na velocidade com que um agente transforma uma premissa errada em código, testes, relatórios, registros e instruções. Gerar leva minutos. Verificar com cuidado costuma levar mais tempo.
Quando a produção cresce mais depressa que a capacidade de verificação, aparece uma dívida: artefatos que parecem concluídos, mas cujo significado ninguém confirmou de verdade.
A Microsoft Research criou o DELEGATE-52 para estudar fluxos longos de edição delegada em 52 áreas profissionais. No experimento divulgado com 19 modelos, até sistemas de ponta corromperam em média 25% do conteúdo dos documentos ao final de interações longas. Documentos maiores, conversas mais extensas e arquivos distratores pioraram o resultado. Isso não quer dizer que todo documento de escritório perderá exatamente um quarto do significado. O mecanismo é mais importante: alterações localmente aceitáveis podem se acumular até danificar o resultado, enquanto a interface continua transmitindo calma.
O mesmo problema pode caber numa resposta em JSON perfeitamente tipada. O schema confirma que status existe; verificar se esse estado descreve o trabalho é outra tarefa.
O que conta como prova de conclusão?
Pedir ao agente para "revisar o próprio trabalho" pode ser útil como uma etapa adicional. É uma base fraca para confiabilidade porque o modelo pode reutilizar a mesma interpretação errada que produziu a resposta.
Uma revisão crítica publicada na TACL encontrou pouca evidência de que modelos orientados apenas por prompts corrijam os próprios erros de forma confiável sem um sinal externo útil, exceto em tarefas muito favoráveis à autocorreção. O resultado melhora quando o sistema recebe feedback externo confiável.
Eu começaria perguntando qual evidência poderia revelar o erro sem depender da explicação que o produziu.
Primeiro, use verificações determinísticas quando elas existirem: schemas, tipos, aritmética, compilação, regras de acesso, restrições do negócio, detecção de duplicatas.
Depois, examine o estado externo. Execute o código e os testes relevantes. Abra o documento que o agente realmente criou. Consulte o registro alterado no banco e compare com o estado anterior. Um formulário enviado precisa de recibo ou status confirmado; uma afirmação factual precisa de fonte primária. Numa mensagem enviada, confira o destinatário, o texto final e o estado da entrega.
Depois disso, um modelo revisor pode ampliar a revisão semântica preliminar. Ele consegue encontrar omissões, contradições e desvios de escopo. Dê critérios e evidências explícitos. Calibre o resultado com avaliações humanas. A revisão precisa de alguma coisa que permita questionar a resposta original. Trocar apenas o prompt pode deixar a mesma suposição errada no lugar.
Por fim, envolva uma pessoa quando não existir uma referência confiável, valores entrarem em conflito, as consequências forem sérias ou alguém precisar aceitar o risco residual.
Quando leio "tarefa concluída", quero conseguir chegar ao resultado: o teste, o registro alterado, o arquivo real, a fonte ou a confirmação de entrega. O relatório me ajuda a encontrar a evidência. Depois posso decidir se ela responde ao que foi pedido.
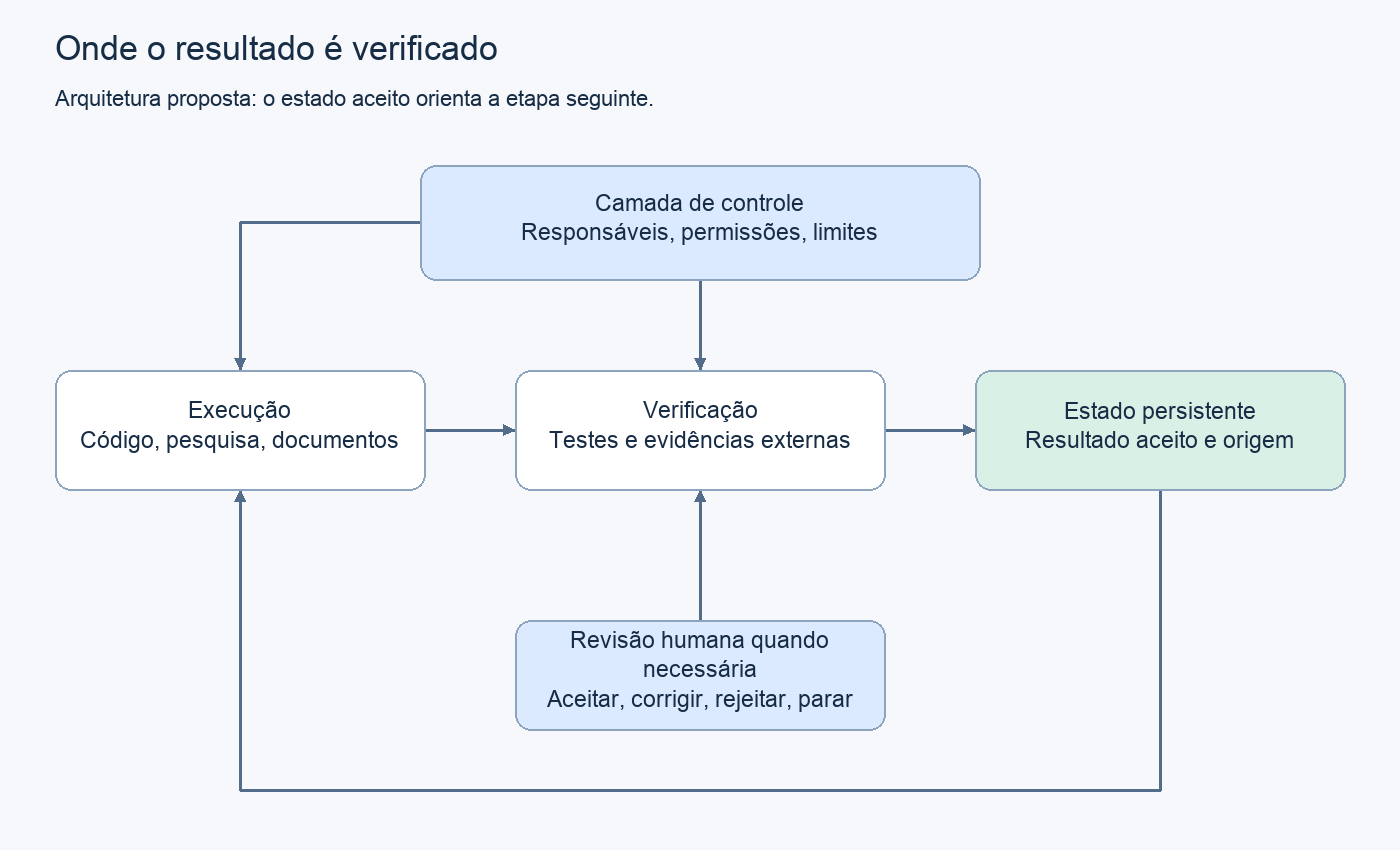
Vários agentes conseguem discutir até encontrar a verdade?
A ideia é atraente: deixe vários agentes debaterem, votarem e corrigirem uns aos outros.
Às vezes, múltiplas tentativas ajudam. Revisões independentes podem expor falhas diferentes. Mas concordância não é verdade. Modelos parecidos, usando fontes parecidas, podem repetir o mesmo viés. A maioria mostra consistência entre amostras. Não mostra contato com a realidade.
O artigo "Should We Be Going MAD?", publicado na ICML de 2024, testou vários protocolos de debate multiagente e concluiu que eles não superavam de forma confiável métodos mais simples, como autoconsistência e conjuntos de caminhos de raciocínio. Alguns sistemas melhoraram depois de um ajuste cuidadoso. Isso torna o resultado mais interessante: debate é um método com condições e custos, não um botão universal de precisão.
Um estudo da EACL de 2026 analisou o desvio do problema em debates longos. A discussão pode se afastar da pergunta original por causa de feedback ruim, falta de progresso e raciocínio pouco claro. Mais rodadas podem produzir mais texto e, ao mesmo tempo, deixar a tarefa real cada vez menor na atenção de todos.
Se a divergência envolve um número que podemos calcular ou um registro que podemos consultar, eu faria isso antes de outra rodada de debate. A conversa passa a ter alguma coisa concreta para examinar.
Use um conselho apenas quando uma escolha real tiver várias respostas defensáveis. Mantenha o processo limitado:
- Faça uma pergunta precisa.
- Dê a todos os mesmos critérios de decisão.
- Recolha posições iniciais independentes antes da leitura cruzada.
- Separe afirmações, evidências, premissas e contradições.
- Permita uma resposta dirigida às divergências importantes.
- Use um árbitro com uma regra de decisão declarada.
- Termine depois de uma rodada fixa e preserve a posição minoritária.
Não force consenso. Às vezes, o resultado correto é uma divergência bem definida e uma decisão humana.
Onde uma pessoa realmente ajuda?
Colocar um botão de aprovação antes de toda chamada de ferramenta parece seguro. Logo a pessoa começa a clicar de forma mecânica, porque o sistema pergunta demais e explica de menos.
O botão continua ali, mas a pessoa já não examina cada decisão. Eu preferiria concentrar essa atenção onde ela consegue mudar o resultado.
Um ponto útil de controle humano tem quatro características:
- A decisão pode mudar o resultado de forma importante.
- A ação é difícil de reverter ou afeta pessoas, dinheiro, permissões, dados privados ou canais públicos.
- A pessoa recebe um pacote compacto de evidências, não o log completo da execução.
- A pessoa pode editar, rejeitar, reverter ou interromper o processo.
Redigir um e-mail pode ser uma tarefa autônoma. Enviá-lo a uma pessoa específica atravessa outra fronteira. Uma pesquisa pode rodar durante horas. Publicar a conclusão no nome de alguém exige uma decisão separada. O sistema pode preparar um pagamento, uma mudança de permissão ou um plano de exclusão. A execução fica atrás de um limite firme.
A orientação da OWASP sobre agência excessiva traduz a mesma ideia para a engenharia: reduza a funcionalidade e as permissões das ferramentas, evite ferramentas abertas quando possível e aplique autorização nos sistemas de destino. O trabalho publicado pela Anthropic sobre contenção traz um exemplo ainda mais direto. Num exercício controlado de red team, um prompt malicioso entregue como se viesse do usuário provocou exfiltração de credenciais em 24 de 25 repetições daquele mesmo prompt. A conclusão dizia respeito ao ambiente: limites de sistema de arquivos e de rede precisam bloquear a ação, qualquer que seja a intenção aparente do modelo ou do usuário.
A instrução escrita e o ambiente têm funções diferentes aqui. A instrução explica o que deve acontecer; o ambiente limita o que a operação consegue fazer.
Quem revisa também precisa de prática independente suficiente para perceber quando a cadeia inteira está respondendo à pergunta errada. Como formar e manter essa competência merece um artigo próprio.
Como eu montaria esse sistema hoje?
Para um sistema como o projeto de contabilidade, eu percorreria esta sequência.
| Decisão | O que precisa ficar explícito |
|---|---|
| Defina o resultado aceito | Não comece com "pesquise o tema" ou "construa o aplicativo". Diga qual é o artefato, quem vai usá-lo, quais propriedades são obrigatórias, quais efeitos são proibidos e qual evidência comprovará a conclusão. |
| Verifique se um agente é necessário | Se a regra pode ser escrita em código, escreva código. Se o caminho é conhecido, monte um fluxo. Use um agente quando o próximo passo depender de uma observação e não puder ser totalmente definido com antecedência. |
| Divida o trabalho por artefatos | Cada etapa deve produzir um objeto inspecionável: registro de fontes, plano, patch, relatório, tabela, diff ou registro de decisão. "O agente trabalhou nisso" não é um artefato. |
| Dê um responsável a cada fronteira compartilhada | Use um único processo de escrita para estado mutável, um responsável pelo merge e um processo para resolver conflitos. Memória compartilhada sem responsabilidade vira uma sala onde todos deixaram um bilhete e ninguém sabe qual ainda vale. |
| Aplique as permissões fora do prompt | Separe leitura, escrita, envio, publicação, pagamento e exclusão. Use credenciais com escopo, áreas de trabalho isoladas, regras de rede e autorização explícita no sistema de destino. O prompt pode explicar uma fronteira. O ambiente precisa aplicá-la. |
| Verifique as transições importantes | Não coloque um verificador caro depois de cada frase. Verifique onde um erro entraria no estado compartilhado, produziria um efeito externo, contaminaria a próxima etapa ou tornaria o retrabalho caro. |
| Limite todos os ciclos | Defina o máximo de tentativas, tempo, custo, condições de falta de progresso, estados finais e caminho de escalonamento. "Tentar de novo" não é uma política de recuperação. |
| Compare com uma alternativa simples | Um sistema multiagente precisa superar um bom fluxo ou um único agente com ferramentas em resultado aceito, cobertura, tempo ou custo total. Se não superar, a arquitetura adicional ficou sem função. |
| Transforme incidentes em testes | Cada resultado rejeitado, correção humana real e incidente de produção deve acrescentar um caso ao conjunto de regressão. Assim, a correção fica preservada de uma forma que permite verificar a próxima versão, em vez de permanecer enterrada numa conversa antiga. |
Por que a arquitetura virou o trabalho?
Quando comecei aquele sistema de contabilidade, achei que o principal valor dos agentes estava em escrever código mais depressa. Depois entendi que a velocidade era apenas a condição de entrada.
O trabalho real era definir fronteiras entre módulos, preservar fontes de verdade, separar permissões, registrar decisões, verificar as transições em que um erro se espalha e impedir que o mesmo agente escreva a realidade e depois certifique que ela está correta.
Isso acrescenta trabalho no início. Mas, depois que uma suposição se espalhou por vários módulos, encontrar e corrigir todas as suas consequências também dá trabalho.
O que quero desse sistema é bastante prático. Quero ver o que mudou, o que sustenta a mudança e o que continua em aberto. Assim posso deixar a próxima etapa seguir sem reconstruir todo o histórico mais uma vez.
Aplicações práticas
- Defina a conclusão por meio de evidências externas, não pelo relato do agente sobre si mesmo.
- Use primeiro verificações determinísticas, depois examine o ambiente real e só então acrescente revisão por modelo e por pessoa quando necessário.
- Trate debate entre modelos como método especializado, não como fonte de verdade.
- Coloque aprovação humana em pontos de decisão importantes, com possibilidade de reversão, e forneça um pacote compacto de evidências.
- Aplique permissões em ferramentas, credenciais, ambientes isolados e sistemas de destino.
- Limite cada ciclo por tempo, custo, número de tentativas, progresso e estado final.
- Transforme toda falha séria e correção humana em teste de regressão.
Em poucas palavras
Quero conseguir chegar do relatório de conclusão a um resultado que posso examinar. Conforme o sistema cresce, isso exige manter a evidência junto do trabalho, conter erros antes que a próxima etapa os utilize e dar a uma pessoa uma oportunidade real de interromper ou mudar uma decisão importante.
Denis Ostapenko · ORCID 0009-0006-2630-7280
Fontes
- Microsoft Research, LLMs Corrupt Your Documents When You Delegate
- Kamoi et al., When Can LLMs Actually Correct Their Own Mistakes?, TACL 2024
- Smit et al., Should We Be Going MAD?, ICML 2024
- Becker et al., Stay Focused: Problem Drift in Multi-Agent Debate, EACL 2026
- NIST, AI Risk Management Framework Core
- OWASP, LLM06:2025 Excessive Agency
- Anthropic, How We Contain Claude Across Products